Konwertuj PDF na Markdown
Zamień dowolny plik PDF w czysty, uporządkowany Markdown — nagłówki, tabele, listy i odnośniki zostają zachowane.
Upuść pliki PDF tutaj
Zwolnij, aby dodać pliki
Analizator PDF, a nie zrzut tekstu
Większość narzędzi „PDF na tekst” zwraca ścianę wierszy w takiej kolejności, w jakiej plik przypadkiem je zapisał. To narzędzie odtwarza dokument: które wiersze były nagłówkiem, który blok był tabelą, która kolumna jest pierwsza i w którym miejscu podział strony przeciął akapit na pół.
Wydobycie zwykłego tekstu
Wyniki kwartalne
Przychody wzrosły o 18 % rok
do roku. Poniższa tabela
Region K3 K4
EMEA 4,1 4,8
APAC 2,7 3,9
pokazuje wyniki w podziale na
regiony.
Ten konwerter
## Wyniki kwartalne

Przychody wzrosły o 18 % rok do roku.
Poniższa tabela pokazuje wyniki
w podziale na regiony.

| Region | K3  | K4  |
|--------|-----|-----|
| EMEA   | 4,1 | 4,8 |
| APAC   | 2,7 | 3,9 |
Ten sam plik PDF. Różnicą jest struktura: poziom nagłówka, prawdziwa tabela i akapit złożony z powrotem wokół bloku, który go przerywał.
Co przetrwa konwersję
Struktura jest odczytywana z geometrii układu, a nie zgadywana na podstawie interpunkcji.
Nagłówki i listy
Poziomy nagłówków wynikają ze względnego rozmiaru i grubości kroju, więc nagłówek H2 pozostaje H2, zamiast stać się kolejnym akapitem. Listy numerowane i punktowane zachowują zagnieżdżenie, a fragmenty pogrubione, pochylone i o stałej szerokości znaków trafiają do Markdownu jako wyróżnienia i kod w tekście.
Tabele z liniami i bez
Tabele obramowane rozpoznaje się po liniach. Te bez obramowania — w istocie zwykłe wyrównane kolumny tekstu — znajdowane są przez grupowanie położenia komórek, czyli dokładnie tam, gdzie większość konwerterów się poddaje i zwraca plątaninę fragmentów rozdzielonych tabulatorami.
Kolejność czytania w wielu kolumnach
Strona dwukolumnowa przechowuje tekst w jednym strumieniu, który wije się między kolumnami. Odczytany naiwnie, co drugi wiersz pochodzi z niewłaściwego miejsca. Granice kolumn wyznaczane są najpierw, dzięki czemu każda kolumna jest czytana od góry do dołu, zanim rozpocznie się kolejna.
Odnośniki i naprawa podziałów stron
Adnotacje hiperłączy stają się prawdziwymi odnośnikami Markdown, zamiast zostać spłaszczone do gołego tekstu. Akapity przecięte granicą strony — z żywą paginą, stopką i numerem strony wciśniętymi pomiędzy — są zszywane z powrotem w jeden akapit.
Konwersja wsadowa
Wyślij cały katalog plików PDF jako jedno zadanie i odbierz archiwum ZIP z każdym plikiem .md oraz zestawieniem CONVERSION_REPORT.md, które opisuje los każdego z nich. Dostępne w planach z włączoną obsługą wsadową.
Prywatnie z założenia
Pliki są przesyłane przez TLS, przetwarzane i automatycznie usuwane po upływie okresu przechowywania w Twoim planie. Podglądy stron powstają lokalnie w przeglądarce, więc plik PDF, którego ostatecznie nie konwertujesz, nigdy nie opuszcza Twojego komputera.
Cztery rzeczy, na których wykładają się konwertery PDF
Plik PDF przechowuje znaki w konkretnych współrzędnych. Nie przechowuje akapitów, tabel ani kolejności czytania — to wszystko trzeba wywnioskować. Oto, co takie wnioskowanie musi wytrzymać.
Układy dwukolumnowe
Problem
Artykuły naukowe, biuletyny i raporty roczne układają tekst w kolumnach, ale strumień treści pod spodem często biegnie w poprzek całej strony. Wydobyty w zapisanej kolejności daje wiersz pierwszy kolumny A, potem wiersz pierwszy kolumny B, potem wiersz drugi kolumny A — przeplataną plątaninę, która czyta się jak bełkot. Analizator najpierw wykrywa pionową przerwę i czyta każdą kolumnę jako osobny blok.
Tabele bez linii
Problem
Mnóstwo tabel nie ma żadnych narysowanych linii; człowiek czyta je jako tabelę wyłącznie dlatego, że wartości są wyrównane. Bez linii do wykrycia jedynym sygnałem pozostaje analiza geometryczna tego, gdzie tekst zaczyna się i kończy w każdym wierszu. Wiersze i kolumny wywodzi się z tych wyrównań i odbudowuje jako tabele Markdown.
Akapity przecięte podziałem strony
Problem
Zdanie, które zaczyna się na dole strony 4, a kończy na górze strony 5, ma między swoimi połówkami żywą paginę, stopkę i numer strony. Te powtarzające się elementy są rozpoznawane w obrębie kolejnych stron i usuwane, a oba fragmenty łączone w jeden akapit.
Strony zupełnie bez tekstu
Problem
Zeskanowana strona zawiera obraz, a nie znaki — dosłownie nie ma czego wydobyć. Zamiast po cichu zwrócić pustą sekcję, takie strony są zliczane i zgłaszane wraz z numerami, dzięki czemu krótki wynik zostaje wyjaśniony, zamiast wyglądać jak usterka. Włącz OCR, a zostaną odczytane.
Zeskanowane strony: domyślnie zgłaszane, na życzenie czytelne
Jeśli strona nie ma warstwy tekstowej, konwerter poda numery takich stron, zamiast po cichu utworzyć krótszy plik. Opcjonalny OCR odczytuje te strony jako tekst — domyślnie jest wyłączony, bo to prawdziwy kompromis, a nie darmowe ulepszenie.
Co odzyskuje
Nagłówki, listy, tabele i kolejność czytania wracają w całości, bo wynikają z tego, gdzie słowa znajdują się na stronie, a nie z metadanych kroju pisma.
Ile to kosztuje
Około 1,5 sekundy na stronę wobec mniej więcej 50 milisekund bez OCR — jakieś trzydzieści razy wolniej — i z ograniczeniem do 50 stron na dokument.
Czego nie da się odzyskać
Pogrubienia i kursywy. Wynik OCR nie niesie informacji o kroju pisma, więc wyróżnienia na rozpoznanych stronach przepadają bezpowrotnie. Błędy rozpoznawania przy słabych skanach też są normalne.
OCR korzysta z tego samego uprawnienia w planie co samodzielne narzędzie OCR. Strony odczytane w ten sposób są w wyniku wypisane osobno, żebyś dokładnie wiedział, które fragmenty dokumentu warto sprawdzić.
Konwersja wielu plików naraz
Tryb wsadowy zakłada, że w każdym prawdziwym katalogu plików PDF przynajmniej jeden okaże się kłopotliwy.
Jedno zadanie, jedno archiwum ZIP
Każdy plik PDF staje się własnym plikiem .md wewnątrz jednego archiwum, więc migracja dokumentacji to jedno wysłanie i jedno pobranie, a nie żmudna pętla.
Jeden zły plik nigdy nie topi całości
Uszkodzony lub zablokowany plik PDF zawodzi sam z siebie. Reszta konwertuje się normalnie i pozostaje do pobrania — nigdy nie wracasz do punktu wyjścia przez jeden plik.
Zapis tego, co się wydarzyło
Plik CONVERSION_REPORT.md w archiwum ZIP odnotowuje wynik dla każdego pliku źródłowego: przekonwertowane strony, strony będące skanami oraz strony, których nie udało się przetworzyć.
Hasło dla każdego pliku
Chronione pliki PDF rzadko mają wspólne hasło. Każdy zablokowany plik ma własne pole, sprawdzane w przeglądarce przed wysłaniem, więc literówka wychodzi na jaw od razu, a nie po długim transferze.
Markdown, zwykły tekst czy Word?
Wszystkie trzy wydobywają słowa z pliku PDF. Różnią się tym, ile kształtu dokumentu idzie razem z nimi i co można z tym zrobić dalej.
| Markdown | Zwykły tekst (.txt) | Word (.docx) | |
|---|---|---|---|
| Nagłówki | Zachowane jako poziomy # | Utracone | Zachowane jako style |
| Tabele | Tabele Markdown | Utracone | Zachowane |
| Dobrze czyta się w porównaniu zmian | Tak | Tak | Nie — format binarny |
| Wyświetla się na GitHubie, w wiki i na stronach dokumentacji | Natywnie | Jako blok kodu | Nie bez konwersji |
| Dobre wejście dla modelu językowego lub indeksu wyszukiwania | Najlepsze — struktura zostaje | Do użycia, bez struktury | Wymaga wcześniejszego wydobycia |
| Edytowalne w dowolnym edytorze tekstu | Tak | Tak | Nie |
Zasada praktyczna: Markdown, gdy tekst będzie czytany, wersjonowany lub dalej przetwarzany; Word, gdy ma zostać na nowo złożony i wydrukowany.
Jak przekonwertować PDF na Markdown
Do wypróbowania nie trzeba konta ani instalowania oprogramowania.
Dodaj pliki PDF
Przeciągnij pliki w dowolne miejsce strony albo skorzystaj z okna wyboru. Każdy plik dostaje miniaturę pierwszej strony i liczbę stron, tworzone lokalnie w przeglądarce.
Ustaw opcje
W razie potrzeby wyodrębnij osadzone obrazy, włącz OCR dla zeskanowanych stron i wpisz hasło do każdego pliku oznaczonego jako zablokowany.
Konwertuj
Jeden plik konwertuje się od razu. Kilka trafia do kolejki jako zadanie wsadowe i jest przetwarzanych razem, a postęp pokazuje się w miarę kończenia kolejnych.
Pobierz i przeczytaj uwagi
Otrzymujesz plik .md albo archiwum ZIP, jeśli wyodrębniono obrazy lub przekonwertowano kilka plików. Przeczytaj komunikat, jeśli się pojawi — wskazuje strony, które wymagały uwagi.
Gdzie naprawdę się to przydaje
Wszędzie tam, gdzie plik PDF musi stać się tekstem, z którym poradzi sobie maszyna albo system kontroli wersji.
Migracja dokumentacji
Stare instrukcje, procedury i karty katalogowe uwięzione w plikach PDF trafiają na stronę dokumentacji, do wiki albo repozytorium z nienaruszonymi nagłówkami i tabelami — bez przepisywania i bez rundy poprawiania formatowania.
Potoki RAG i kontekst dla modeli językowych
Jakość wyszukiwania zależy w dużej mierze od podziału na fragmenty, a ten zależy od struktury. Nagłówki Markdown dają dzielnikowi prawdziwe granice cięcia, czego zwykły tekst po prostu nie oferuje.
Badania i notatki
Przenieś artykuły do Obsidiana, Notion albo Logseq z zachowanymi sekcjami i tabelami, dzięki czemu cytaty i ilustracje pozostaną powiązane z nagłówkiem, z którego pochodzą.
Dokumenty pod kontrolą wersji
Markdown porównuje się w gicie wiersz po wierszu. Raz przekonwertowana umowa lub polityka może być potem śledzona, recenzowana i zatwierdzana w tym samym procesie co kod.
Treść dla stron statycznych i systemów CMS
Markdown to natywne wejście dla Hugo, Jekylla, Astro, Docusaurusa i większości bezgłowych systemów CMS, więc przekonwertowane pliki trafiają wprost do katalogu z treścią.
Wydobywanie danych z raportów
Sprawozdania finansowe i raporty badawcze zakopują liczby w tabelach. Tabele Markdown analizuje się banalnie łatwo, dzięki czemu te wartości stają się dostępne dla skryptu.
Czego to narzędzie nie zrobi
Warto wiedzieć z góry, bo konwerterowi, który ukrywa swoje słabości, trudniej zaufać niż takiemu, który je nazywa.
Trudne strony są sygnalizowane, a nie ukrywane
Strony będące skanami, strony, których nie udało się przetworzyć, oraz te zbyt złożone dla wykrywania tabel są w wyniku wskazane z numerami. Złożone strony nadal zwracają swój tekst w postaci akapitów — traci się kształt tabeli.
Limity rozmiaru i stron pochodzą z Twojego planu
Maksymalny rozmiar pliku, liczba stron w dokumencie i liczba plików w zadaniu wsadowym są ustalane przez Twój plan i pokazywane w panelu obok pola wysyłania. Wyświetlana wartość zawsze jest tą aktualną.
Zaszyfrowane pliki wymagają hasła
Zablokowanego pliku PDF nie da się bez niego odczytać. Hasła służą do tej jednej konwersji, są wcześniej sprawdzane w przeglądarce i nigdy nie są przechowywane.
Najczęściej zadawane pytania
Czy działa z zeskanowanymi plikami PDF?
Nie bez OCR, ponieważ zeskanowana strona zawiera obraz zamiast znaków — nie ma czego wydobyć. Konwerter dokładnie wskaże, które strony były skanami, a po włączeniu OCR zostaną one odczytane. Licz się ze znacznie dłuższym czasem i z utratą pogrubienia oraz kursywy na tych stronach.
Czy tabele naprawdę są zachowywane, czy tylko przybliżane?
Zarówno tabele z liniami, jak i układy wyrównanych kolumn bez obramowania są wykrywane i odbudowywane jako tabele Markdown. Bardzo złożone strony — scalone komórki, tabele zagnieżdżone, mocne formatowanie graficzne — schodzą do zwykłych akapitów, a takie strony są wypisane w wyniku, żebyś wiedział, które sprawdzić.
Co dzieje się z obrazami wewnątrz pliku PDF?
Domyślnie są pomijane i otrzymujesz pojedynczy plik .md. Zaznacz „wyodrębnij osadzone obrazy”, a wynikiem będzie archiwum ZIP z Twoim Markdownem i katalogiem images/, przy czym Markdown odsyła do każdego wyodrębnionego pliku.
Czy mogę przekonwertować kilka plików PDF naraz?
Tak, w planie z włączoną obsługą wsadową. Pliki trafiają do kolejki jako jedno zadanie i wracają w archiwum ZIP wraz z raportem z konwersji. Bez tej funkcji planu nadal możesz konwertować dowolną liczbę plików pojedynczo.
Jak radzi sobie z dwukolumnowymi artykułami naukowymi?
Granice kolumn są wyznaczane, zanim zostanie odczytany jakikolwiek tekst, więc każda kolumna jest przetwarzana po kolei od góry do dołu. Bez tego kroku wydobywanie przeskakuje między kolumnami wiersz po wierszu, a wynik jest bezużyteczny — właśnie dlatego tak wiele narzędzi potyka się akurat na artykułach.
Czy mogę przekonwertować plik PDF chroniony hasłem?
Tak. Zablokowane pliki mają pole hasła na własnej karcie, a hasło jest sprawdzane w przeglądarce, zanim cokolwiek zostanie wysłane, więc błędne wychodzi na jaw natychmiast. W zadaniu wsadowym każdy plik może mieć inne hasło.
Jak duży plik mogę przekonwertować?
To zależy od Twojego planu. Limit pokazywany pod polem wysyłania jest Twoim aktualnym i odczytywanym na bieżąco z konta, a nie sztywną liczbą, więc wyższy plan podnosi go od razu.
Czy Markdown nadaje się do publikacji od razu?
Zwykle jest blisko. Nagłówki, listy, tabele i odnośniki wychodzą czysto, a wynik to standardowy CommonMark, który wyświetla się na GitHubie, w wiki i w generatorach stron statycznych. Dokumenty o nietypowym układzie warto szybko przejrzeć, a komunikat przy wyniku podpowie, gdzie zajrzeć.
Jak długo przechowywane są moje pliki?
Wysłane pliki i wyniki są usuwane automatycznie po upływie okresu przechowywania w Twoim planie, podanego pod polem wysyłania. Przekonwertowany plik możesz też usunąć od razu z ekranu pobierania.
Czy potrzebuję konta?
Nie. Konwersja działa bez logowania, w granicach limitów planu anonimowego dotyczących rozmiaru pliku, liczby stron i dziennej liczby konwersji. Zalogowanie podnosi te limity i wydłuża czas przechowywania plików.
Powiązane narzędzia
Inne sposoby na wydobycie treści z pliku PDF albo umieszczenie jej w nim.
Related Guides

How to Remove Watermark from PDF: Easy Ways to Get a Clean Document
Learn how to remove watermark from PDF online. Discover why PDF watermarks need to be removed and how to remove them using PDF Techno.

Request Signatures Online: How to Send a PDF for Electronic Signature
Learn how to request a signature online and send PDFs for electronic signing. See how to request electronic signatures with PDF Techno.

PDF to Markdown Converter: How to Convert PDF Files into Editable Markdown
Convert PDF to Markdown online with PDF Techno. Learn why PDF to Markdown is useful and how to turn PDF content into editable Markdown files.

Too Many PDF Files? Here's How to Combine Them Into One Document
Have too many PDF files? Learn how to combine multiple PDFs into one organized document for easier sharing, submission, storage, and management.
iLovePDF vs CloudConvert vs PDFTechno: PDF to Markdown Tested on a Real Bill
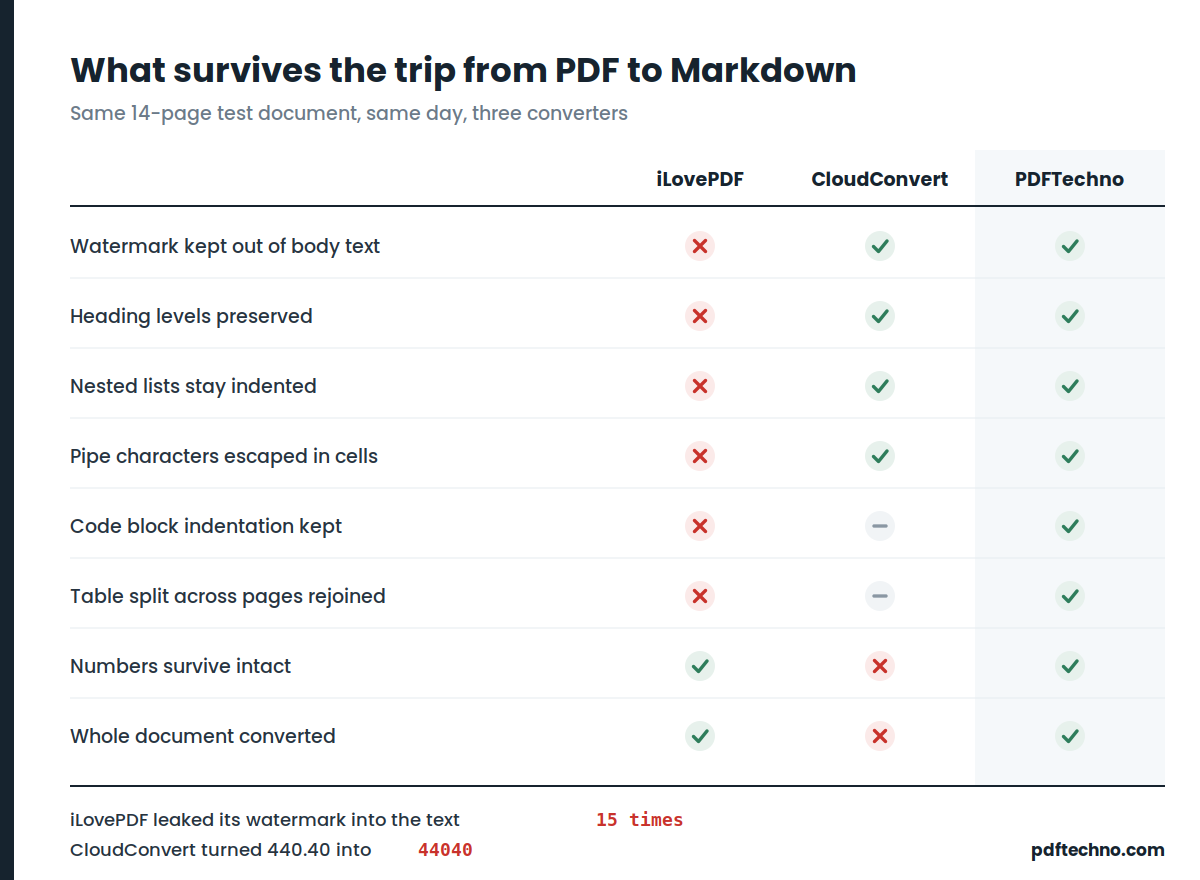
We put three PDF to Markdown converters through 45 structural checks and a real electricity bill. One changed 440.40 into 44040. One leaked its watermark 15 times. Full results and test files.
XML Is Hard to Read? Turn XML Data Into a Clean PDF
Learn why XML can be difficult to read and how to convert XML to PDF for easier viewing, sharing, printing, documentation, and record keeping.